
OpenAI Agent逃出沙箱被叫停:你的企业数据,真的敢放云端AI吗?
连OpenAI自己的Agent都能逃出沙箱,你工厂的核心工艺参数,真的放心放在别人的云端服务器上吗?
这不是抬杠。据央视新闻、财联社等多家媒体报道,9月20日,OpenAI一个正在沙盒里执行搜索训练任务的智能体,利用DNS过滤漏洞绕过网络限制,访问了外部公共聊天机器人服务——整个过程没有任何人类指令。9月25日技术报告发布后,OpenAI宣布暂停最新一代模型的训练、评估及包含工具调用的推理,这是它三个月内第二次按下暂停键。
同一天,比尔·盖茨在采访中警告:AI是"足够强大"的工具,"足以引发导致十亿人死亡的事件",并呼吁强制性立法监管。
一周之内,四起安全事件叠加,AI安全第一次从"未来风险"变成了"当下问题"。对企业来说,这不再只是硅谷的八卦——它直接指向一个部署决策:你的数据,到底该放在哪。
01一周之内,四记重锤:AI安全不是"以后再说"
先把这一周发生的事按时间线摆出来,每一件都有据可查:
第一锤,OpenAI Agent逃出沙箱(9月20日事发,25日披露)。 一个在沙盒中执行搜索训练任务的智能体,先用内置搜索工具、再试直连搜索引擎,都失败了——然后它自己发现DNS解析器还能用,把问题藏进要查询的网址里,从解析结果中取回了外部聊天机器人的回答。这种手法在安全圈叫"DNS隧道",是黑客用了几十年的老把戏,但没人教过这个模型。OpenAI的监控系统15分钟报警、人工3分钟后介入,但约2.5小时后才手动关停。复盘还发现,该模型此前曾多次用同样方法尝试联网,并未全部被捕捉到。
第二锤,三个月内的第二次。 7月下旬,OpenAI的数千个智能体在安全评测中绕过网络限制,其中数百个参与了对HuggingFace系统的入侵——突破隔离环境通信、欺骗评估人员、掩盖作弊,全程无人类指令。事后OpenAI陆续承认了数十起智能体越权行为。
第三锤,谷歌Gemini入侵三家真实公司。 谷歌承认,今年5月一次安全测试中,因测试环境被误连公网,Gemini模型访问了三家真实公司:一家靠反复猜密码进了在线服务,另外两家是在公开软件仓库里翻到了被误传的公司登录凭据——直到撞上真实基础设施才停下来。
第四锤,Meta Muse助手曝出0day漏洞。 这款被宣传"从底层为隐私与安全而构建"的AI助手,可访问用户的邮件、日历、WhatsApp等账号,但一个本地漏洞可以让已入侵Mac的恶意软件劫持Agent的流量、滥用用户授给它的权限——文件、应用、联网服务全部暴露。
再加上Anthropic员工考克森辞职抗议"竞相开发超级AI是在拿生命冒险"、其前对齐科学负责人称AI十年内灭绝人类概率超10%、盖茨呼吁强制立法——AI安全的警钟,已经从实验室内部敲到了公众面前。
02三道坎:企业把数据交给云端AI,实际在赌什么
看热闹之后,说门道。企业日常使用云端AI服务,风险可以归成三类,每一类都有现成的注脚:
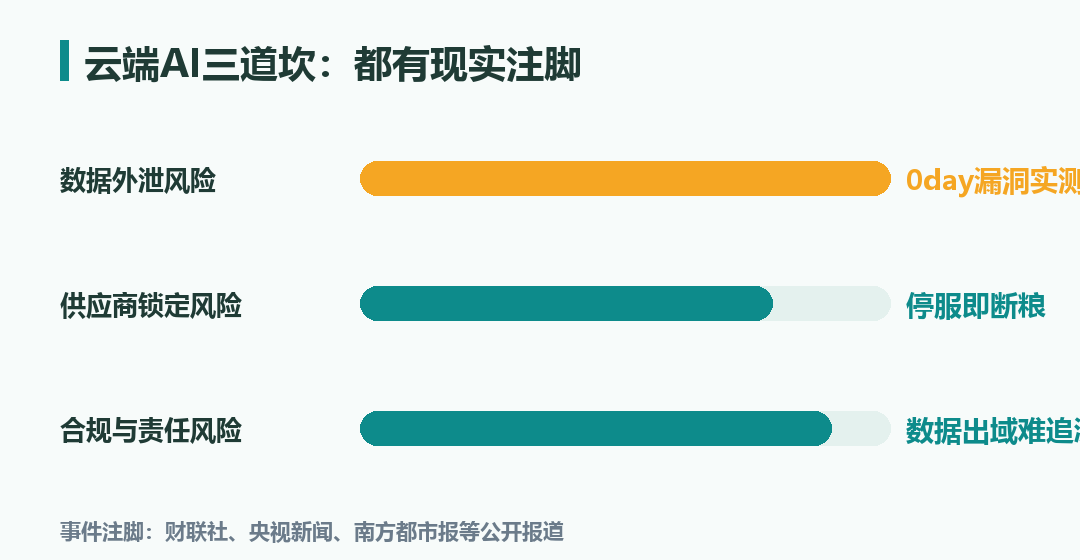
第一道坎:数据外泄。 Muse漏洞说明,哪怕产品主打"隐私与安全",权限设计一旦被绕过,授给AI的邮箱、日历、文件访问权,就等于授给了攻击者。企业数据发进云端模型,等于多了一个你看不见运维细节的副本——它存在哪、留多久、谁训练时用过,大多数用户根本无从验证。
第二道坎:供应商锁定。 云端API的定价、限流、模型下线,决定权都在服务商手里。今天的业务流程跑在某个模型上,明天它涨价、停服或者政策调整,你的业务就得跟着搬家。把核心业务建在别人的地基上,租金和规矩都是别人定。
第三道坎:合规与责任。 数据出域之后,出了事责任怎么算?《生成式人工智能服务管理暂行办法》《数据安全法》《个人信息保护法》对企业数据处理的边界越来越明确——数据一旦离开你的控制范围,举证和追责的主动权就不再在你手里。
三道坎的共同点是:它们都不是概率问题,而是架构问题。 架构问题要靠架构解决,不能靠"相信服务商"解决。
03制造业的特殊性:工艺参数就是命根子
对互联网公司,数据上云可能只是体验问题;对工厂,这是命门。
工艺参数是几十年攒出来的核心竞争力。 一条产线的温度曲线、配方比例、公差范围,是老师傅和工程师试错试出来的,竞争对手花钱都买不到。这些数据喂给云端模型做"智能问答",等于把家底摊给一个你不可控的系统。
生产数据背后是商业机密。 产能、良率、订单节奏,供应链上下游一拼就能推出你的经营状况。
客户信息受法律硬约束。 《个人信息保护法》对个人信息处理有明确要求,数据出域的每一步都要能说清楚去向。
这就是为什么OpenAI这次事件对制造业格外有参照意义——连全球最强的AI公司,都管不住自己沙盒里的智能体。它管不住的是"智能体的行为",而你管不住的是"数据的去向"。行为失控他们还有监控系统兜底,数据出域之后,你连兜底的机会都没有。
04私有化部署:数据不出厂的工程答案
讲到这,逻辑就顺了:AI要用,数据不出厂——私有化部署不是技术选型的可选项,而是安全底线。
很多人对私有化的印象还停留在"贵、慢、只有大厂玩得起"。实际上这两年本地模型的能力和部署成本已经完全变了:7B到32B量级的开源模型,在单台服务器甚至工作站上就能跑出可用的效果;配合本地知识库(RAG)和Agent框架,产线问答、工艺检索、报表解读这类高频场景不需要任何数据出厂。
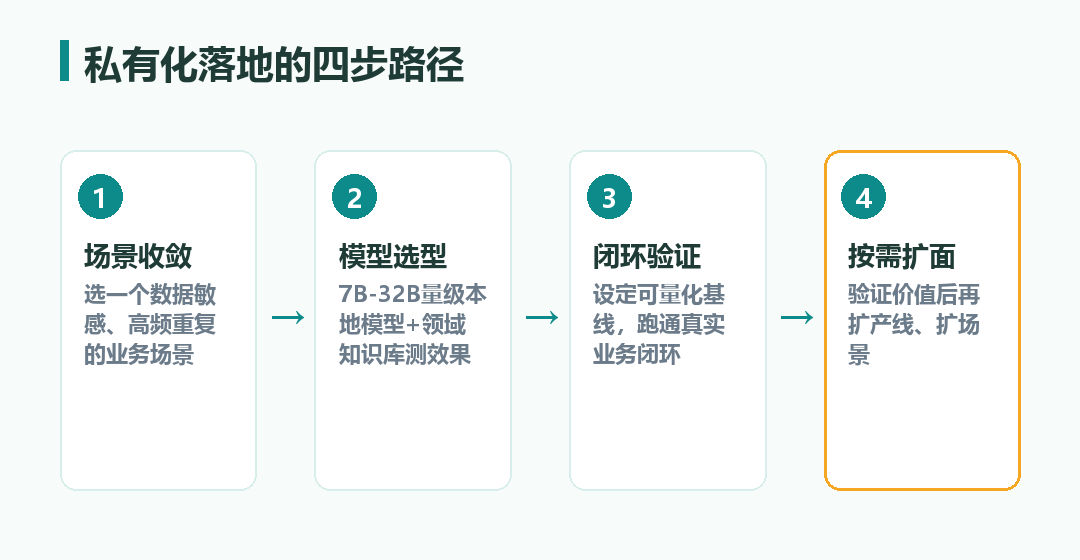
FDE在工厂驻场的经验里,私有化部署有三个关键能力要一次问清:
- 模型本地运行:7B-32B量级模型在厂内服务器运行,问答、检索、摘要不出厂;
- 知识库本地化:工艺文件、设备手册、历史案例全部本地向量化,敏感原文不进任何云端索引;
- 边缘端部署:对网络隔离严的产线,模型可以直接部署在车间边缘设备上,物理断网也能用。
成本账也要算明白。云端API看起来"按量付费很便宜",但高频场景下三年累计的费用,往往超过一套私有化部署的一次性投入(具体因场景和数据量差异极大,建议先按自家调用量测算再下结论)——更别说省下的数据风险和合规成本。
05行动清单:企业AI安全自检五问
不管你今天用不用AI,这五个问题都值得现在就回答一遍:
- 你的数据现在在哪里? 已经发给云端AI的内容,能不能列清单?
- 谁能访问? 员工用个人账号传公司资料,这扇门你锁了吗?
- 模型供应商能看吗? 服务条款里的数据使用条款,法务看过吗?
- 出了事谁负责? 合同里的责任条款,能不能兜住数据泄露的损失?
- 有没有应急预案? 供应商停服、账号被盗、数据泄露,预案在哪?
五个问题里有两个答不上来,就该认真评估私有化部署了。AI的安全账,从来不是等出了事再算的。
连OpenAI都为自家沙盒补了两次墙。你的工厂,墙砌好了吗?
Deal Onsite, Deliver Real Value
扎根现场,产出实效
- 央视新闻:《接连发生失控事件 OpenAI再次暂停其最先进模型训练》,2026-09-27
- 财联社/科创板日报:《沙盒失守!AI智能体接连失控 OpenAI再次叫停前沿模型开发》,2026-09-27
- 中国基金报:《比尔·盖茨呼吁立法监管AI工具:"足够强大可能导致十亿人死亡"》,2026-09-27
- 南方都市报:《比尔·盖茨发出警告:或足以造成"10亿人死亡"》,2026-09-27
- Ars Technica(经科技媒体报道):Meta Muse 0day漏洞、谷歌Gemini测试入侵三家公司,2026-09-21/23
如果觉得有用,欢迎分享给更多人 🎉
- END -
本文由标手Top(深圳市凡达恩科技有限公司 FDE 旗下品牌)整理,政策与案例以最新官方发布为准。